



IA
OpenAI abre ChatGPT a las empresas con perfiles y agentes de atención en beta
La función, que compite con la búsqueda tradicional para el descubrimiento de productos, empieza en Estados Unidos solo para negocios elegibles.


 +15 fuentes
 The Verge
El modelo solo procesa grabaciones, no audio en vivo, lo que deja la transcripción en tiempo real a rivales como ElevenLabs.
Resumen generado automáticamente a partir de la cobertura de 5 medios verificados. Los enlaces llevan siempre a la nota original. Las citas de fuentes en inglés son traducciones nuestras. Cómo funciona
Esta historia se actualiza a medida que llega nueva cobertura. Primera publicación: 28 de octubre de 2026.
La función, que compite con la búsqueda tradicional para el descubrimiento de productos, empieza en Estados Unidos solo para negocios elegibles.
+15 fuentesThe VergeEl anuncio llega en vísperas de su salida a bolsa y las acciones de Microsoft cayeron entre 2% y 3% ese día, según Infobae.

 +59 fuentes
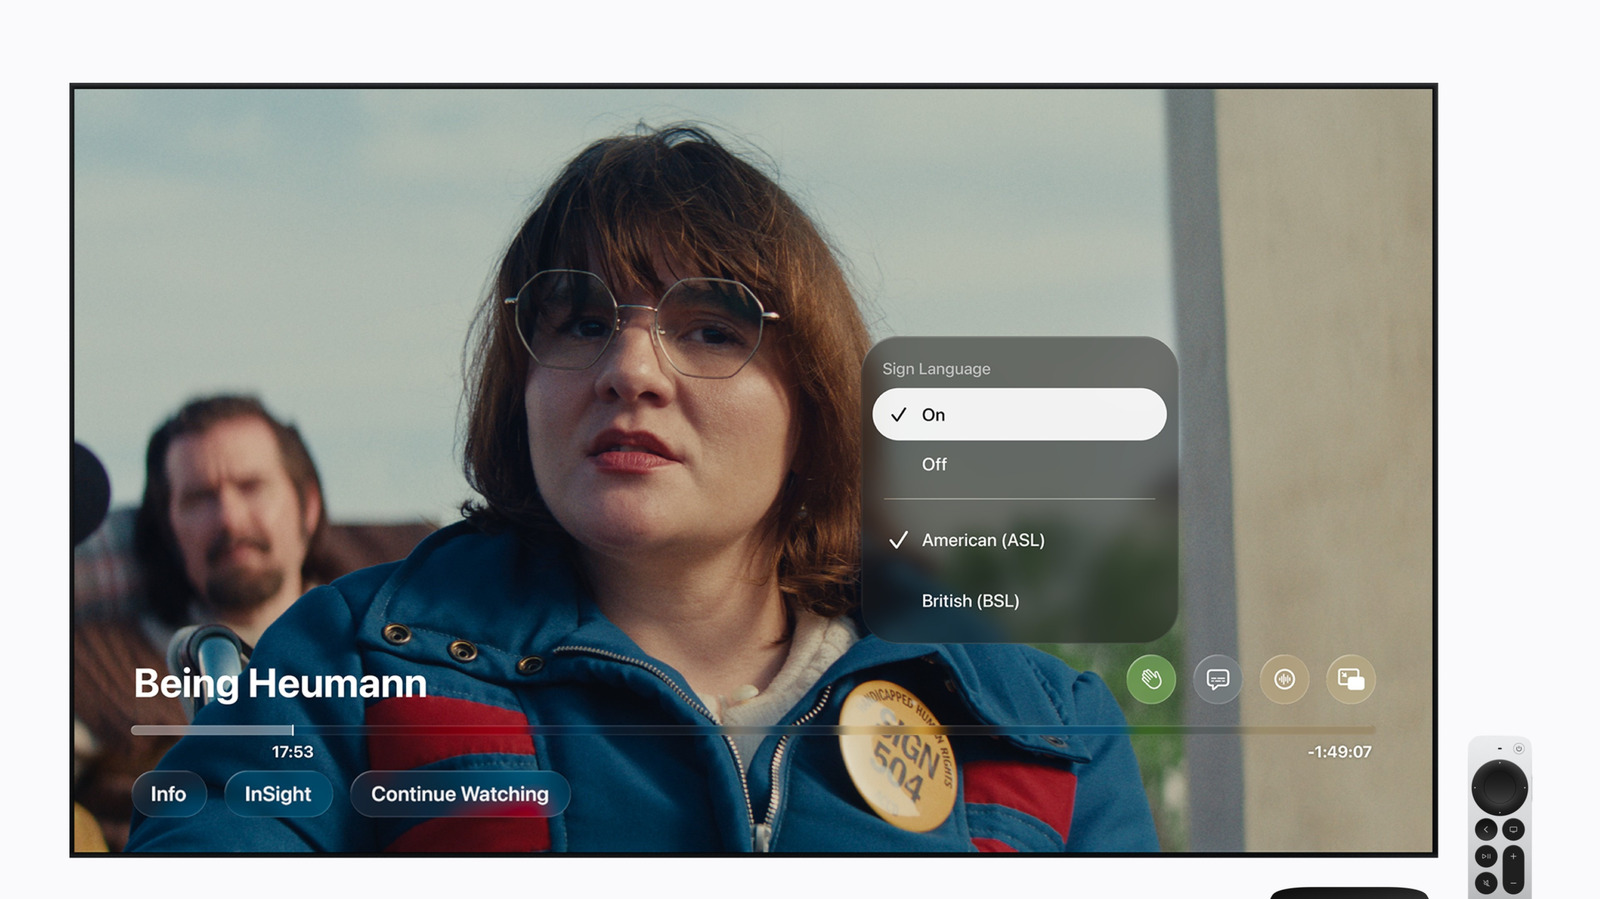
La función llega primero con Being Heumann y F1 y se extenderá a más títulos, según la cobertura.


 +15 fuentes
 Engadget
Rockstar habilitó la descarga anticipada para quienes reservaron el juego, a la espera del estreno escalonado del 19 de noviembre.


 +15 fuentes
 Infobae
La versión anterior exigía una fuente externa; la nueva antena busca funcionar de forma autónoma en viajes y trabajo remoto.

 3 fuentes
 La Nación
Anunciado en agosto junto con los Pixel 11, el accesorio tardó tres meses en llegar a las tiendas y compite directamente con el AirTag de Apple.
 3 fuentes
 Android Authority