Qué cambióGoogle publicó en su blog Gemini Robotics 2.5, al que describe como su modelo visión-lenguaje-acción más capaz para mejorar la destreza, fiabilidad y seguridad de los robots.
Google DeepMind presentó Gemini Robotics 2.5, un modelo de acción visión-lenguaje (VLA) que genera movimientos del robot, y la propia Google lo describe como su modelo más capaz de este tipo.
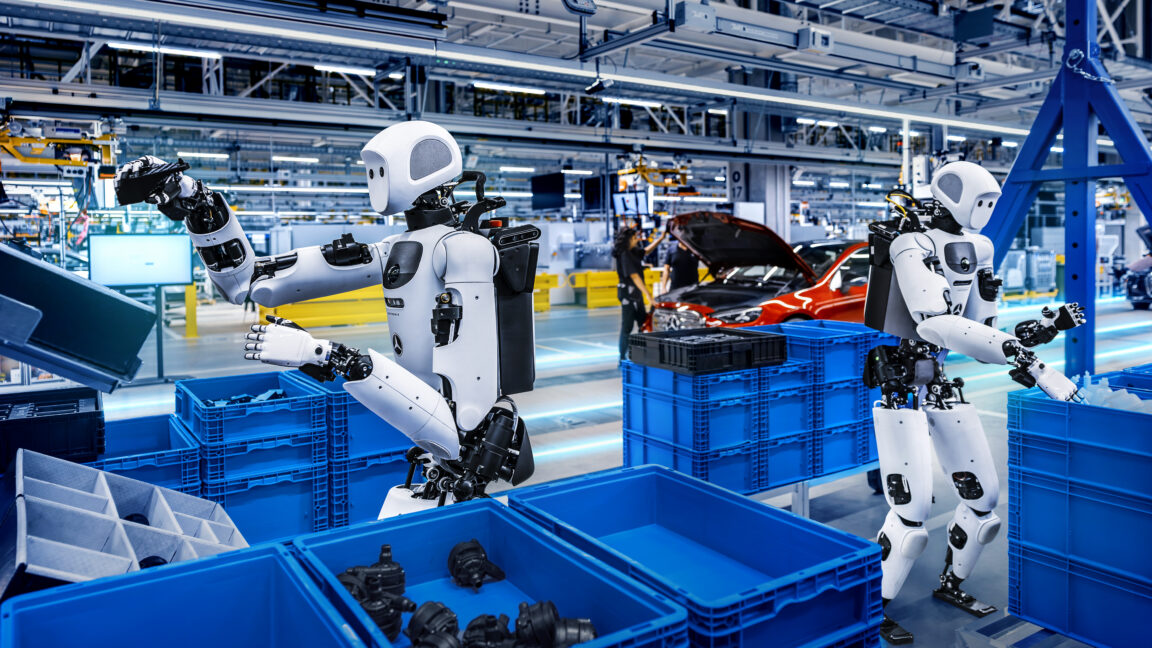
Según The Decoder, el modelo se probó con Apptronik en líneas de producción activas de Mercedes-Benz en Hungría y Alemania, donde el humanoide Apollo 2 clasificó piezas metálicas con una tasa de éxito reportada del 96 %.
Según Humanoids Daily, Gemini Robotics 2.5 tuvo éxito entre un 30 % y un 100 % más que Gemini Robotics 2 en más de 200 tareas, en una comparación que proviene de la propia cobertura y no ha sido verificada por separado.
Ars Technica describe la arquitectura en dos capas: Gemini Embodied Reasoning planifica la tarea a partir de instrucciones y video en vivo, y Gemini Robotics 2.5 traduce ese plan en acciones del robot.
Ars Technica informa de que DeepMind publicó también un punto de referencia de seguridad de código abierto llamado "ASIMOV-jailbreak", aunque no detalla sus resultados.
Humanoids Daily indica que el modelo solo está disponible para socios, mientras que Google no precisa en su anuncio una fecha de disponibilidad general.
Resumen generado automáticamente a partir de la cobertura de 4 medios verificados. Los enlaces llevan siempre a la nota original. Las citas de fuentes en inglés son traducciones nuestras. Cómo funciona
Esta historia se actualiza a medida que llega nueva cobertura. Primera publicación: 10 de noviembre de 2026.


 +37 fuentes
 Engadget